AIR sporer merkevarenevnelser, sentiment og Share-of-AI-Voice på tvers av alle 5 store AI-motorer — OpenAI, Anthropic, Google, Perplexity og Mistral — med 10 modell-konfigurasjoner og trend-endringer over tid. Hvert aggregert tall har egen sample size og confidence band, slik at et snapshot på 4 kjøringer aldri presenteres som fasit.
Bygget for ledere som mottar en delt AIR-rapport, og byråer som pitcher overvåking til kunder.
- MYTE
- «3LA mangler trendanalyse eller Share-of-Voice.»
- FAKTA
- 5 motorer, 10 modell-konfigurasjoner, trend-endringer over tid med confidence bands på hvert aggregert tall. Denne siden er beviset.
Hvert tall AIR rapporterer leveres med sample size og confidence band — troverdige tall, ikke bare flere tall.
Et lavt antall kjøringer flagges automatisk. AIR runder aldri et snapshot opp til en påstand.
Fire datapunkter, sporet kontinuerlig på tvers av motorer — ikke et engangsscan.
5 store AI-motorer · 10 modell-konfigurasjoner
OpenAI (ChatGPT / GPT-5.2), Anthropic (Claude Sonnet 4.5 og 4.6), Google (Gemini 2.5 / 3 / 3.5 Flash og 3.1 Pro), Perplexity (Sonar og Sonar Pro), Mistral Large — sporet i samme kjøring, ikke stikkprøver én og én.
Trend-endringer over tid
Share-of-AI-Voice-bevegelse uke for uke og måned for måned, ikke én statisk score.
Sentiment per motor
Positiv, nøytral eller negativ vinkling, brutt ned per motor — motorene er uenige, og AIR viser det.
Sample-size-transparens
Hvert aggregert tall har n= og confidence band, slik at snapshots med lite volum aldri fremstår som avgjort fakta.
AIR kjører samme merkevare-spørring på tvers av motorer med fast frekvens, deretter aggregeres med synlig usikkerhet.
- 01
Definer spørringen
Merkevare- og kategori-prompten AIR kjører på tvers av alle motorer.
- 02
Kjør på tvers av 5 motorer · 10 konfigurasjoner
Samme prompt, samme tidsvindu, alle 5 AI-motorer spurt parallelt på tvers av 10 modell-konfigurasjoner.
- 03
Score nevnelser og sentiment
Hvert svar analyseres for tilstedeværelse, sentiment og sitering.
- 04
Publiser med confidence bands
Aggregerte tall leveres med n= og confidence band, aldri et nakent tall.
AIR bruker samme standard på 3LA selv som på din merkevare — ingenting skjules.
Confidence bands beregnes fra antall kjøringer. Et 4-kjørings-snapshot gir et bredt bånd; et 40-kjørings-snapshot smalner det inn — båndet vises, det skjules ikke.
Score publiseres når denne sidens audit passerer ≥ 90.
Se din merkevares Share-of-AI-Voice
Kjør en gratis AIR-prøve og se confidence band før du ser scoren.
Mål endring, ikke bare ett enkelt svar
Bruk samme spørsmålssett og modelloppsett når du sammenligner perioder. Endrer du spørsmål eller motorer, endrer du også undersøkelsen. Skill derfor reelle utslag i merkevaresynlighet fra forskjeller som skyldes et nytt måleoppsett.
Behold dokumentasjonen ved siden av poengsummen
Vurder utvalgsstørrelse, konfidensbånd og de underliggende svarene før du trekker konklusjoner. En merkevarenevnelse, en kildehenvisning og en positiv beskrivelse er ulike resultater. AIR synliggjør forskjellene uten å gjøre et lite utvalg til en påstand om hele markedet.
Ofte stilte spørsmål
Hva overvåker AIR?
Merkevarenevnelser, sentiment og Share-of-AI-Voice på tvers av OpenAI, Anthropic, Google, Perplexity og Mistral med trend-endringer over tid.
Hvor ofte kjører AIR?
Konfigurerbar tidsplan — vanligvis ukentlig. Samme prompts mot alle motorer i samme sesjon.
Hva er et konfidensbånd?
Viser hvor mye et tall kan variere gitt utvalgets størrelse. AIR viser alltid båndet.
Hva er Share-of-AI-Voice?
Hvor ofte merkevaren din siteres sammenlignet med konkurrenter for samme prompts.
Kan jeg spore konkurrenter?
Ja. AIR tester samme prompts for din merkevare og konkurrenter side om side.
FROM THE BLOG
Latest field notes.
Why we rebuilt the 3LA audit: Honest numbers and page-aware scoring
A review of one audit report found four figures that did not hold up. We traced each one to the code, fixed it, and changed how the audit judges a page: by what kind of page it is. The growing amount of AI-slop is why 3LA now focus on precision even more.
AI SEO Tools Comparison in 2026: A Strategist's Honest Take
AI visibility tools answer three different questions. Is my site built so AI can read and trust it? How often does AI mention me? Is a change in those mentions real? Classic SEO suites answer the first question only partly. Daily trackers such as Peec AI and Profound answer the second, across many engines. The Three-Layer Approach (3LA) answers the first with deterministic structural scoring and the third with repeated sampling and confidence intervals. Most teams need more than one of these. The useful thing is to know which question each tool is actually answering.
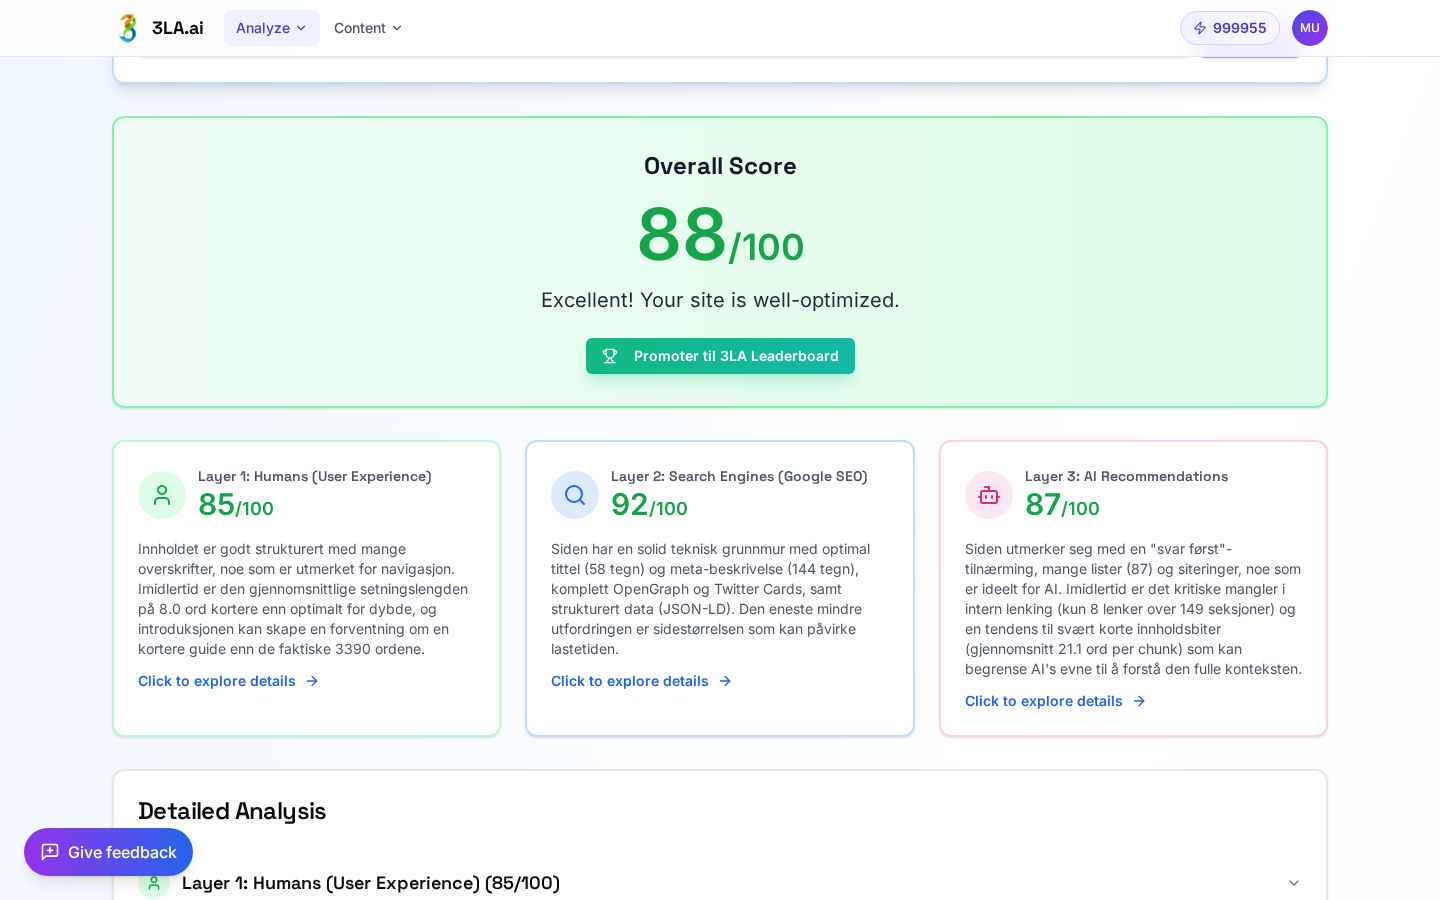
A Practical Setup Guide for 3la.ai
Want your brand to be preferred and cited by ChatGPT, Perplexity and Google AI Overviews? This guide walks you through setting up 3la.ai in under an hour, so you can close visibility gaps, optimise your content and compete in AI search (GEO).